DIA专栏(三) | 我们真的知道什么是“数据集”吗? ——重新认识数据集的内涵、边界与构建原则
近年来,随着人工智能、大数据、生物医学研究以及数据产品的发展,“数据集(Dataset)”已经成为科学研究、临床医学和数字产业中使用频率最高的术语之一。从“胃癌数据集”“肺癌数据集”“高质量数据集”“多模态数据集”,到“AI训练数据集”“全套数据集”,几乎所有涉及数据建设的工作都会以数据集作为基础。然而,一个看似人人熟悉的概念,却长期缺乏统一而严谨的认识。我们经常讨论如何建设数据集、共享数据集、评价数据集,却很少追问一个更基本的问题:
我们真正理解什么是数据集吗?
目前,大多数教材和文献将数据集定义为“按照一定规则组织的数据集合(Collection of Data)”。这个定义并没有错误,但它更多停留在概念层面,而缺乏工程意义。它没有回答数据集建设中最重要的几个问题:什么样的数据才能构成一个数据集?数据集的边界在哪里?为什么不能把所有与某种疾病相关的数据简单放在一起称为一个数据集?数据集最小的组织单位是什么?数据集与数据库、数据仓库之间又有什么区别?这些问题如果没有得到回答,我们认为的数据集便很容易退化为“数据的堆积”,而不是一种可以共享、复用、评价和持续建设的数据组织单元。
这种模糊在医学领域尤为突出。例如,我们经常听到胃癌数据集这一说法,但不同专业背景的人所理解的内容却完全不同。临床医生想到的是患者病历、治疗方案和随访信息;病理医生想到的是组织切片、病理报告和免疫组织化学结果;影像医生想到的是CT、MRI和PET图像;生物信息学研究者想到的是基因组、转录组和蛋白组数据;人工智能研究者想到的则是模型训练所需要的标注样本。每个人都认为自己讨论的是胃癌数据集,实际上描述的却是不同的数据对象、不同的数据结构和不同的数据内容。
这说明,胃癌数据集实际上只是一个疾病主题,而不是一个严格定义的数据集。疾病名称决定的是研究领域,却不能决定数据集的结构。一个真正的数据集,不应由疾病名称定义,而应由数据对象、数据边界和数据模型共同定义。
事实上,目前大量临床数据库和科研数据库建设普遍采用一种“字段累积”的思路,即以已有CRF表、医院信息系统或实验记录为基础,把所有可能采集的数据字段不断加入数据库,希望做到数据越多越好。然而,这种方式往往导致数据集边界越来越模糊、字段越来越庞杂、采集成本越来越高,不同机构之间的数据也越来越难以整合,更大的问题是一采集数据量为起点,等积累之后却再考虑是否有用的思路。究其原因,并不是数据不足,而是缺少了数据集设计最基本的思想——先定义数据集,再收集数据,而不是先收集数据,再试图形成数据集。
重新认识数据集,首先需要明确,数据集并不是数据的简单集合,而是一种具有明确组织结构和语义边界的数据单元。从最基本的数据组织层次来看,数据元素(Data Element)是描述对象某一属性的最小信息单位,例如年龄、性别、身高、HER2表达或CT值。多个具有明确语义关系的数据元素,按照预先定义的数据模型共同构成数据集的结构定义(Dataset Definition),明确数据集应当描述什么对象、包含哪些属性以及这些属性之间如何组织。
在此基础上,按照数据集的结构定义采集或生成具体数据,形成一条条数据记录(Data Record)。每条数据记录都是数据集结构在某一具体对象上的数据实例;多个遵循同一数据模型、具有相同结构的数据记录,共同构成数据集的实际数据内容,即数据集实例(Dataset Instance)。
由此可以进一步理解,一个真正的数据集至少应同时具备四个基本条件:具有明确的数据对象、具有统一的数据模型、具有清晰的数据边界以及具有一致的数据规范。其中,数据对象决定数据集描述“谁”;数据模型规定数据元素如何组织;数据规范保证不同来源的数据能够保持一致;而数据边界则决定哪些数据属于该数据集,哪些数据不属于该数据集。四者共同决定了一个数据集结构是否真正成立。
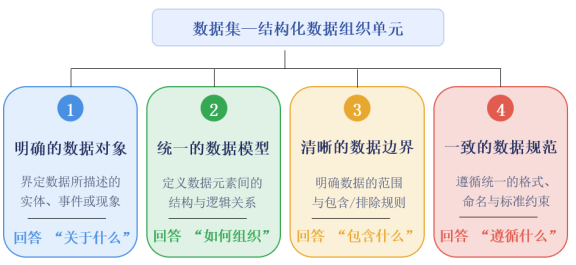
数据边界是目前数据集建设中最容易被忽视的问题,也是决定数据集质量的基础。任何一个数据集都必须回答一个问题:哪些内容属于这个数据集?哪些内容不属于这个数据集?如果不能回答这个问题,那么数据集就没有真正形成。仍以胃癌为例,病理数据、影像数据、基因组数据、代谢组数据、临床数据虽然都与胃癌有关,但它们描述的是不同的数据对象,来源于不同的数据产生过程,具有不同的数据结构和质量规范,因此不能简单地放入同一个数据集中。它们首先应分别形成胃癌病理数据集、胃癌影像数据集、胃癌临床数据集、胃癌组学数据集等多个具有独立边界的数据集,再通过统一的患者标识、样本标识、时间信息和语义模型建立关联,最终形成完整的疾病数据资源体系。换句话说,疾病名称只是数据资源组织的主题,而不是数据集划分的依据。
数据集不仅需要明确边界,还需要明确数据元素的层级。目前,大多数临床数据库设计往往直接采用CRF中的全部字段作为数据集内容,而很少讨论哪些字段是真正构成数据集不可缺少的核心内容。事实上,任何数据集都应首先定义核心数据元素(Core或Mandatory Data Elements),它们决定数据集是否成立;其次定义推荐数据元素(Recommended Data Elements),用于增强数据分析能力;最后定义扩展数据元素(Optional Data Elements),满足不同研究和工程场景的特殊需求。更重要的是,数据元素是否属于Mandatory,并不是其固有属性,而是由数据集的目标决定。例如,对于一般患者数据集,身高和体重可以不是必需项;但如果研究目标是肥胖与胃癌发生风险,则身高和体重便成为计算BMI所不可缺少的数据元素,自然应上升为Mandatory(语义关系的数据元素)。由此可见,数据集的目标决定数据元素的层级,而不是相反论。
因此,一个规范的数据集建设过程,不应从设计数据采集表开始,而应从数据集的结构定义开始。首先明确应用目标,其次明确数据对象,再确定数据集边界,建立数据模型,定义核心数据元素和扩展数据元素,最后才进入数据采集、数据质量控制和应用验证阶段。这种“先定义、后采集”的思想,与目前普遍采用的“先采集、再整理”模式有着本质区别,也是未来高质量数据集建设的重要基础。
值得注意的是,人们今天所说的“高质量数据集”,更多关注的是数据完整性、准确性、一致性和规范性等质量指标。这些当然十分重要,但它们只是数据质量的表现,而不是数据集质量的全部。如果一个数据集本身没有清晰的边界,没有统一的数据对象,没有合理的数据模型,没有明确的核心数据元素,即使所有数据都完整无缺,也难以称为真正意义上的高质量数据集。换言之,高质量数据集首先是一种正确的数据组织方式,其次才是高质量的数据内容。
本文作者认为,有必要重新认识和理解数据集。数据集不应再被简单理解为“相关数据的集合”,而应被定义为:数据集(Dataset)是为实现特定目标,在明确的数据边界内,围绕特定数据对象,依据统一的数据模型和数据规范,对相关数据元素进行结构化定义,并据此组织形成的数据组织单元。
在这一概念下,数据集首先需要通过数据元素及其相互之间的语义关系,定义数据集的结构、范围和边界,并明确核心数据元素和扩展数据元素。在实际数据采集过程中,具体数据按照预先定义的数据集结构形成数据记录;多个遵循同一数据模型、具有一致结构和语义的数据记录,共同构成数据集的实际数据内容。这样的数据集设计能够保证数据被规范采集、持续管理、有效共享和可靠应用。
更重要的是,这一认识为未来不同类型数据集的建设提供了统一的方法学框架。无论是临床数据集、病理数据集、医学影像数据集、多组学数据集,还是人工智能训练数据集,其建设原则在本质上都应保持一致:明确数据对象,界定数据边界,建立统一的数据模型,规范数据元素,并依据预先定义的结构组织数据,而不是简单地不断增加数据字段。只有建立在这一基础上的数据集,才能真正成为科学研究、人工智能训练、数据产品开发以及医学数据资源建设的基本组织单元。
重新认识数据集,并不仅仅是一个概念问题,更代表着一种数据建设理念的转变:从“收集数据”转向“设计数据集”,从“字段堆积”转向“结构定义”,从“主题命名”转向“边界规范”。这种转变将成为未来高质量数据资源建设的重要基础。
在此基础上,下一步需要进一步讨论一个更具应用价值的问题:数据集虽然可以按照统一的方法学框架进行定义和构建,但不同数据集所承担的功能并不相同。传统数据集往往主要作为数据资源进行保存和共享,而面向临床实践和实际应用的数据集,则应进一步围绕具体决策需求组织数据。因此,本文下一篇将进一步讨论如何实现从“资源性数据集”向“决策支持性数据集”的转变。
本文提出的数据集定义及其构建原则,将作为后续临床数据集、病理数据集、医学影像数据集、多组学数据集以及高质量数据集等系列研究的方法学起点,并为建立统一、规范、可共享的数据集体系提供理论基础和数据集构建方法论。
领航视角:王伟业教授
DIA专栏由生物芯片上海国家工程研究中心副主任王伟业教授创建并领衔,围绕各种相关“业务场景”,采用对话方式,与相关行业同仁共同开展系列性探讨,致力于突破认知边界。伟业教授不仅拥有对前沿理论知识和技术的深邃洞察力,更擅长深入临床业务的细枝末节,寻找数据建设和应用与转化的最优解。他拒绝浮于表面的技术堆砌,坚持从真实的临床痛点与具体业务场景出发,还原数据应有的价值,重点建设方法论,最终反馈在临床决策。跟随伟业教授的视角,我们将一起穿透数据的迷雾,探讨如何在复杂的临床环境中,将前沿技术落地为解决实际问题的有效路径。
王伟业教授,美国M.D. Anderson肿瘤中心博士,生物芯片上海国家工程研究中心副主任、生物样本库科学研究院院长、上海数据交易所重大疾病数据行业创新中心副主任、临床转化生物信息中心(CTBI)主任,教育部和上海市环境与儿童健康重点实验室兼职教授。原上海交通大学医学院附属新华医院教授、博士生导师和新华生物样本库(XHBiobank)主任。研究建立"样本价值完整性评估方法”、“生物样本库数字化建设方法”、“DBCase Biobank"专病队列建设模式,数据特征建设方法论以及创建生物数据沙龙系列(BCD)等。发表几十篇SCI文章。
互动福利:免费咨询与方案定制
DIA专栏特别开放3个免费名额,我们将结合您的具体研究领域与项目痛点,为您提供一对一的专属咨询服务,并协助完成数据集构建的初步架构设计。
名额有限,如何参与?
扫描下方二维码,填写信息并提交,我们将根据申请顺序与匹配度,优选3个项目,并尽快与您取得联系,共同探讨如何让数据真正赋能临床转化与科学决策。